«Закрою раздел /admin/ в robots.txt — и его никто не увидит». Это понятная,
но опасная ошибка владельца сайта. Файл robots.txt не ставит дверь с замком: он
оставляет указание для роботов, которые готовы его соблюдать. Если в разделе
лежат закрытые документы или данные пользователей, одного robots.txt
недостаточно.
Что сообщает robots.txt
Robots Exclusion Protocol — это соглашение между сайтом и автоматическими
клиентами: поисковыми, архивными и другими роботами. Файл размещают по адресу
https://example.com/robots.txt. В нём робот находит группу правил для своего
имени или общее правило *.
Минимальный пример:
User-agent: *
Disallow: /drafts/
Allow: /drafts/public-guide.html
Здесь User-agent: * обращается ко всем роботам, Disallow просит не обходить
адреса с началом /drafts/, а Allow делает исключение для одной публичной
страницы. При пересечении правил обычно важнее более точное совпадение пути.
Это правила обхода: они определяют, какие URL робот должен запрашивать, а не
то, кто вообще может открыть страницу.
Стандарт RFC 9309 прямо предупреждает: протокол не является авторизацией. Кроме того, сам список запрещённых путей виден любому, кто откроет robots.txt. Он может подсказать, где искать служебный раздел.
Обход, индексация и доступ — не одно и то же
Обход — это получение роботом страницы по URL. Индексация — сохранение сведений о ней и возможность показать URL в поиске или другом каталоге. Авторизация — проверка прав перед выдачей содержимого. Robots.txt относится только к первому шагу и действует лишь для роботов, которые его соблюдают.
Поэтому URL может остаться известным: на него уже ссылались с другой страницы, он был обработан раньше или оказался в карте сайта. Google Search Central отдельно объясняет, что запрет обхода не равен надёжному исключению адреса из результатов. Для исключения из поисковой выдачи нужны подходящие механизмы индексации; для действительно закрытого содержания — вход в аккаунт, права доступа и проверка их на сервере. Не рассчитывайте на секретность через непубликацию ссылки.
Как применить это к источнику Dzen Chat
При добавлении сайта в Dzen Chat сначала решите, что именно можно использовать в базе знаний. Если сайт уже выражает желаемые границы в robots.txt, включите соблюдение этих правил для источника. Если правило robots.txt предназначено только для поисковой оптимизации и не соответствует составу вашей базы, задайте границы источника отдельно: добавьте только нужный раздел или исключите лишние URL правилами источника. Это решение об объёме материалов, а не способ открыть закрытые страницы.
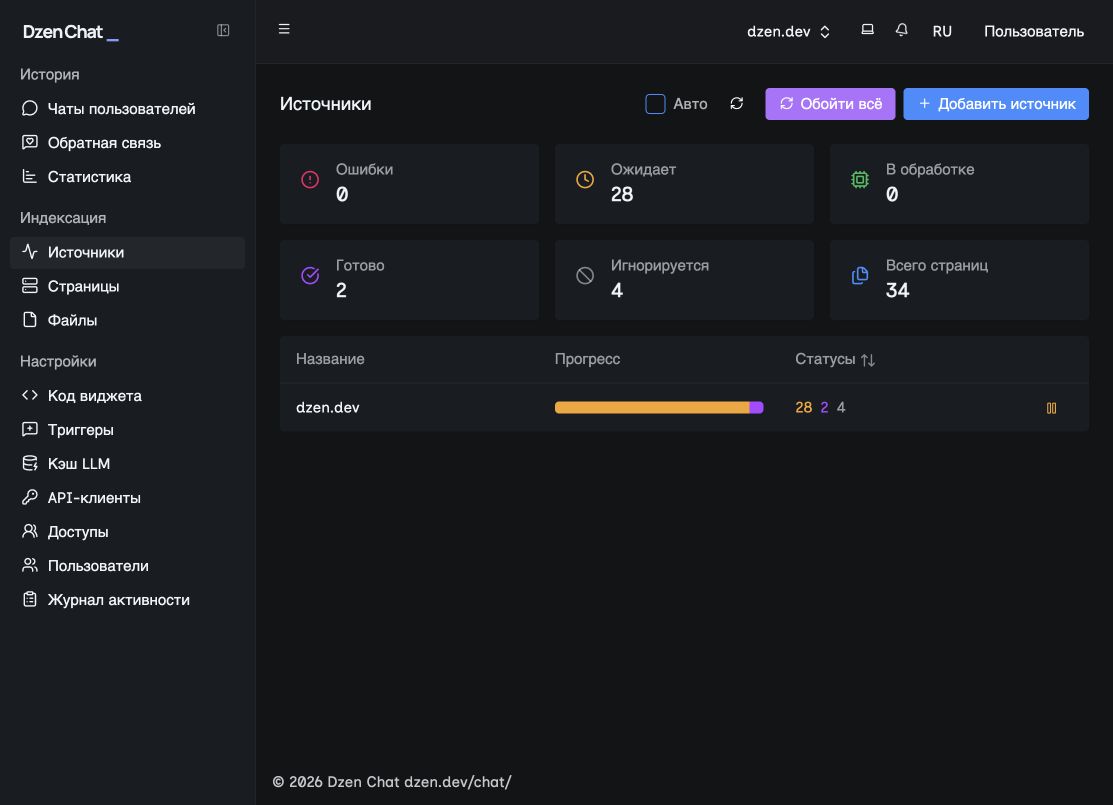
Затем откройте «Источники» и проверьте результат обхода. Нужные публичные страницы должны быть обработаны и готовы к использованию; страницы, исключённые правилами, не должны попасть в состав источника. Проверьте по одному URL из каждой группы после обновления правил — так вы увидите не только сохранённую настройку, но и её результат.
Robots.txt полезен, когда нужно вежливо направить добросовестного робота: например, не тратить обход на черновики или технические дубли. Для защиты закрытого раздела сначала настройте авторизацию, а уже потом используйте robots.txt как дополнительный сигнал. О том, как робот находит страницы, читайте в материале «Что делает поисковый робот, когда обходит сайт», о проверке набора URL — в «Как проверить индекс сайта и исключить лишние страницы», а о карте сайта — в статье о sitemap.
Если хотите проверить границы источника и ответы на своих материалах, свяжитесь с командой Dzen Chat.